Artificial Analysis: Neuer KI-Index straft Open-Weight-Modelle ab
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
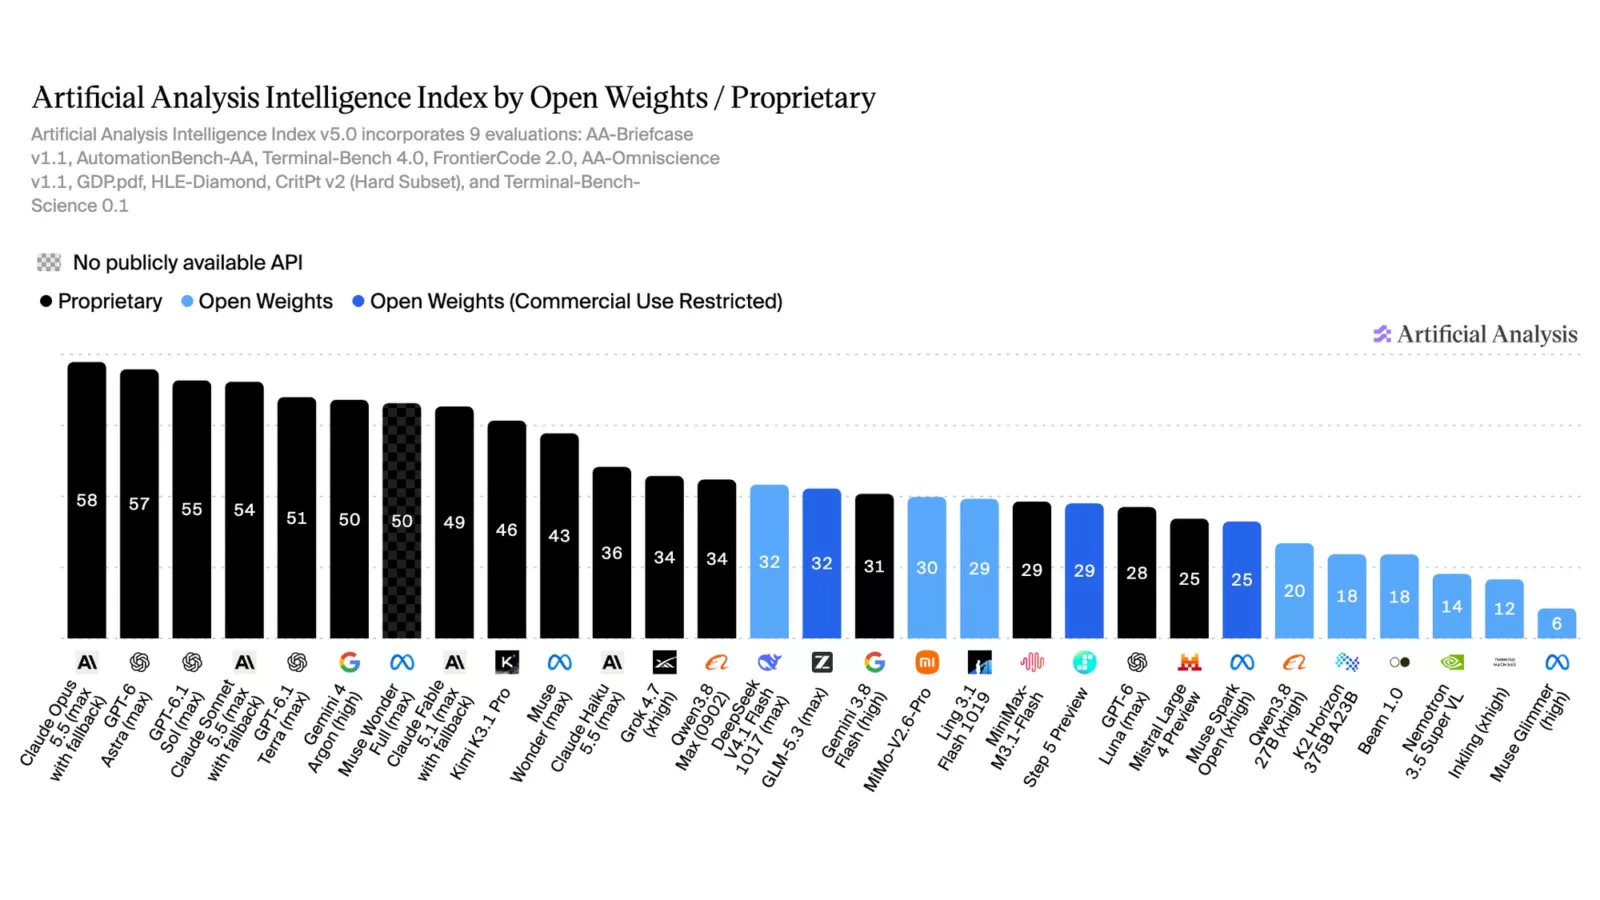
Neue Tests, alte Gewinner und ein böses Erwachen für die offenen Modelle: Der unabhängige Testdienst Artificial Analysis hat soeben die Version 5 seines Intelligence Index veröffentlicht, des wohl meistbeachteten Rankings für KI-Modelle. Weil der Index nun mehrheitlich auf geheimen Testdaten beruht, rutschen vor allem Open-Weight-Modelle aus China massiv ab. Der Abstand zwischen dem besten proprietären und dem besten offenen Modell wächst dadurch von 3 auf 12 Punkte.
Was sich am Index ändert
Laut Artificial Analysis ist es das größte Update seit Jahresbeginn. Der wichtigste Punkt: Rund 60 Prozent des Index beruhen jetzt auf privaten Testsätzen oder zurückgehaltenen Antworten. Damit soll verhindert werden, dass Modelle schlicht auf bekannte Testfragen hintrainiert werden. Der Index besteht aus vier gleich gewichteten Bereichen:
- Wissensarbeit: Aufgaben wie in einem echten Büroalltag, etwa das Bearbeiten von Dokumenten und Automatisierungen.
- Programmieren: Neu ist FrontierCode 2.0, ein privater Test der KI-Firma Cognition. Eine Lösung zählt nur, wenn ein Entwickler sie tatsächlich übernehmen würde.
- Wissenschaft: Neu ist Terminal-Bench-Science mit 70 Forschungsaufgaben, die ein Modell selbstständig erledigen muss, dazu ein besonders schwerer Physik-Test.
- Allgemeinwissen: Eine neue, härtere Version von „Humanity’s Last Exam“ sowie ein Test, der Halluzinationen bestraft.
Gestrichen wurden unter anderem der bekannte Programmiertest SciCode und der Wissensarbeits-Test GDPval-AA.
Das neue Ranking
An der Spitze ändert sich wenig, darunter dafür umso mehr. Im Vergleich zu den Werten der Vorversion, über die Trending Topics kürzlich berichtet hat, sieht das so aus:
- Claude Opus 5.5 (Anthropic): Bleibt mit 58 Punkten an der Spitze.
- GPT-6 Astra (OpenAI): Springt von 53 auf 57 Punkte und damit auf Platz 2.
- GPT-6.1 Sol (OpenAI): Kommt auf 55 Punkte, und das zu rund einem Achtel der Kosten von Opus.
- Claude Sonnet 5.5 (Anthropic): Fällt leicht von 56 auf 54 Punkte.
- Gemini 4 Argon (Google): Sinkt von 53 auf 50 Punkte.
- Muse Wonder Full (Meta): Verliert deutlich, von 56 auf 50 Punkte.
Kein Modell gewinnt alle neun Einzeltests. Opus 5.5 führt in drei davon.
Der Absturz der offenen Modelle
Richtig hart trifft es die Open-Weight-Modelle, deren Gewichte frei verfügbar sind und die jede:r selbst betreiben kann:
- Kimi K3.1 Pro (Moonshot AI): Fällt von 55 auf 46 Punkte. Es bleibt das beste offene Modell, allerdings hat Moonshot die Gewichte noch nicht veröffentlicht.
- DeepSeek V4.1 Flash: Stürzt von 45 auf 32 Punkte ab.
- MiMo-V2.6-Pro (Xiaomi): Verliert 16 Punkte und landet bei 30.
- Muse Spark Open (Meta): Das beste offene Modell aus den USA sinkt von 39 auf 25 Punkte.
Das beste Modell, dessen Gewichte bereits frei verfügbar sind, liegt damit 26 Punkte hinter dem Spitzenreiter. Sogar Anthropics kleines und günstiges Modell Claude Haiku 5.5 schlägt mit 36 Punkten alle offenen Modelle mit veröffentlichten Gewichten. Nicht besser ergeht es Europas Hoffnungsträger Mistral: Dessen noch nicht offenes Vorschaumodell Mistral Large 4 Preview kommt auf 25 Punkte.
Die größten Lücken zeigen sich bei den neuen, schweren Tests. Beim überarbeiteten „Humanity’s Last Exam“ schafft Kimi 37 Prozent, Opus 68 Prozent. Bei den wissenschaftlichen Agenten-Aufgaben kommt Kimi auf 34 Prozent, GPT-6 Astra auf 63 Prozent, die meisten offenen Modelle bleiben unter 10 Prozent.
Testen am Limit wird teurer
Die neuen Tests verlangen den Modellen deutlich mehr ab. Pro Aufgabe erzeugen die Modelle im Mittel rund 59.000 Tokens an Output, zwei Drittel mehr als bisher. Das schlägt sich in den Kosten nieder: Ein Durchlauf von Claude Opus 5.5 auf höchster Stufe kostet laut Artificial Analysis rund 10 Dollar (etwa 9 Euro) pro Aufgabe, GPT-6.1 Sol rund 1,27 Dollar (etwa 1,13 Euro). Wie viel Rechenaufwand man zulässt, macht enorme Unterschiede: Auf der niedrigsten Stufe kommt Opus 5.5 nur auf 35 Punkte.
Ein Ranking ist nur so gut wie seine Tests
Für die offenen Modelle ist das Ergebnis nicht ganz so eindeutig, wie es auf den ersten Blick scheint. Kimi K3.1 Pro führt etwa beim Agenten-Test Terminal-Bench 4.0 das gesamte Feld an, vor allen proprietären Modellen. Zudem hängt das Ranking stark davon ab, welche Tests ein Anbieter auswählt und wie er sie gewichtet: In der Vorversion lag Kimi K3.1 Pro noch auf Platz 4, nur drei Punkte hinter der Spitze. Und weil der Großteil der Testdaten nun geheim ist, lassen sich die Ergebnisse von außen nicht mehr unabhängig nachprüfen. Artificial Analysis setzt dagegen gerade deshalb auf geheime Testdaten, damit Modelle nicht auf bekannte Fragen hintrainiert werden können.