GPT-6 plötzlich auf Platz 1: Artificial-Analysis-CEO erklärt die Index-Updates, die OpenAI halfen
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
Zwei Updates innerhalb weniger Tage, ein neuer Spitzenreiter: Kurz nach dem Launch von GPT-6 Astra hat Artificial Analysis seinen vielbeachteten Intelligence Index gleich zweimal überarbeitet. OpenAIs neues Modell kletterte dadurch von Platz fünf an die Spitze, ex aequo mit Anthropics Claude Fable 5.1 bei jeweils ausgewiesenen 53 Punkten. Der rasche Wechsel wirft eine Frage auf: Warum änderte eine der wichtigsten Bewertungsplattformen für KI-Modelle ausgerechnet jetzt ihre Messlatte?
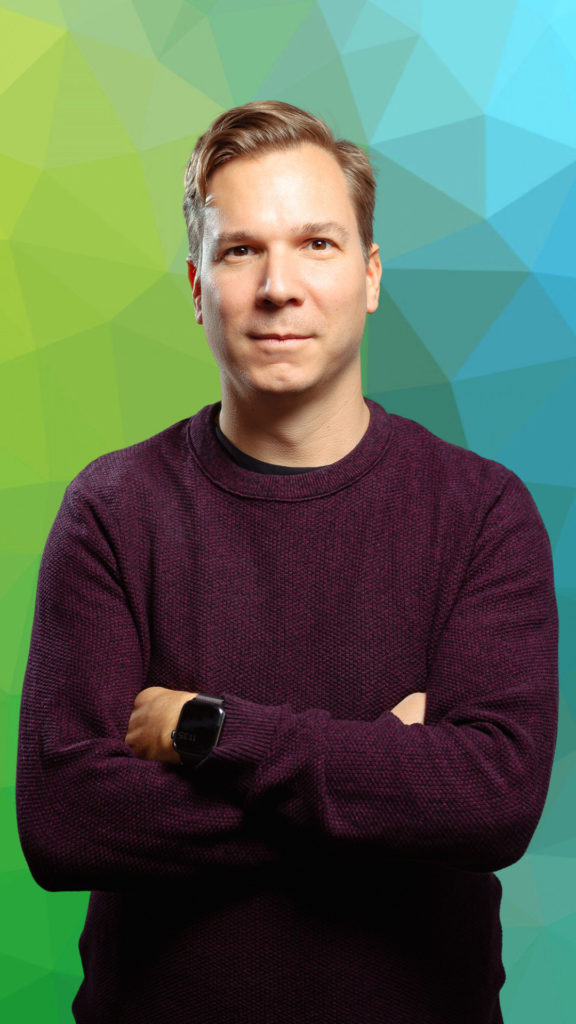
Micah Hill-Smith, Mitgründer und CEO von Artificial Analysis, begründet das Vorgehen auf Anfrage von Trending Topics mit Fähigkeiten der neuen Modelle, die der bisherige Index unzureichend abgebildet habe. Eine gezielte Bevorzugung weist er zurück. „Ich kann versichern, dass wir keine Änderungen vornehmen, um absichtlich einem bestimmten Modell Vorteile zu verschaffen“, sagt Hill-Smith. Ziel sei, Entwickler ein möglichst präzises und nützliches Bild für ihre Entscheidungen zu liefern.
Von Platz fünf zum geteilten Spitzenplatz
Wie stark die Methodik das Ergebnis verändert hat, zeigt die Entwicklung der vergangenen Tage. Im bisherigen Index erreichte GPT-6 Astra 61 Punkte, gleichauf mit seinem Vorgänger GPT-5.6 Sol und hinter Fable 5.1 mit 66 Punkten. Mit Version 4.2 schrumpfte der Abstand zwischen den beiden neuen Spitzenmodellen auf 55 zu 57 Punkte. Version 4.3 brachte schließlich den Gleichstand bei 53 Punkten, wie Trending Topics berichtete.
Die unterschiedlichen Punktestände sind dabei nur innerhalb der jeweiligen Indexversion sinnvoll vergleichbar: Mit jedem Umbau verändert sich die Bewertungsgrundlage. Der Aufstieg von GPT-6 zeigt damit, wie stark die Auswahl und Gewichtung von Tests die Rangfolge beeinflussen können.
Hill-Smith zufolge war genau diese Grundlage zum Problem geworden. „Fable 5.1 und GPT-6 Astra zeigten Fähigkeiten, die Index v4.1 unserer Ansicht nach nicht angemessen erfasste, teilweise weil frühere Modelle mehrere der darin verwendeten Benchmarks bereits ausgereizt hatten.“ Wenn viele leistungsfähige Modelle bei einem Test nahe an die erreichbare Höchstleistung kommen, kann dieser ihre Unterschiede immer schlechter sichtbar machen.
Interne Ergebnisse gaben den Ausschlag
Die Entscheidung für die schnellen Updates sei auf Basis bereits vorhandener Messungen gefallen. „Uns lagen bereits in der Vorwoche interne Ergebnisse vor, die erheblich von dem Bild abwichen, das Index v4.1 zeigte“, sagt Hill-Smith.
Das Team habe entschieden, dass schnelle Aktualisierungen des Index und der Website den Nutzer mehr bringen würden als das Warten auf den ursprünglich geplanten größeren Versionssprung. Deshalb zog Artificial Analysis Tests vor, die bereits für Version 5 entwickelt oder implementiert worden waren.
Damit bestätigt der CEO, dass die Leistungen von Fable 5.1 und GPT-6 Astra den Zeitpunkt der Änderungen beeinflusst haben. Aus Sicht des Unternehmens war die bisherige Zusammenstellung der Tests dem Fortschritt an der Modellspitze nicht mehr ausreichend gewachsen.
Mehr Wissensarbeit, schwierigere Aufgaben, private Testdaten
Die Änderungen sind in den Ankündigungen dokumentiert. Mit Version 4.2 kamen unter anderem AA-Briefcase für komplexe Wissensarbeit und GDP.pdf für die Auswertung umfangreicher Dokumente hinzu. Der wissenschaftliche Wissenstest GPQA Diamond fiel wegen seiner weitgehenden Sättigung aus dem Index.
Zugleich stieg die Gewichtung von Tests mit geheim gehaltenen Aufgaben oder Antworten auf 40 Prozent. Solche Testdaten sollen erschweren, dass Modellentwickler ihre Systeme gezielt auf bekannte Prüfungsaufgaben optimieren.
Mit Version 4.3 folgte der Wechsel von Terminal-Bench 2.1 auf die anspruchsvollere Version 4.0. Außerdem ersetzte AutomationBench-AA den bisherigen Banking-Test durch breiter angelegte Geschäftsabläufe über mehrere Anwendungen hinweg. Die Gewichtung privater Testbestandteile stieg auf 45 Prozent; die Gewichte der übergeordneten Kategorien blieben gegenüber Version 4.2 unverändert. Damit verschob sich die Prüfung weiter in Richtung komplexer Aufgaben, die KI-Agenten selbstständig erledigen sollen.
Wie verlässlich ist eine Rangliste, die sich so schnell verändert?
Für die Aussagekraft einer Rangliste bleibt das Tempo solcher Umbauten eine Herausforderung. Wer kurz nach einem Modellstart auf den Index schaut, kann wenige Tage später eine deutlich andere Reihenfolge vorfinden. Ein Vergleich über die Zeit setzt voraus, dass die zugrunde liegenden Testbedingungen berücksichtigt werden.
Hill-Smith verteidigt den Anspruch seiner Plattform entsprechend offensiv: „Ich bin überzeugt, dass er durchgehend die beste einzelne Kennzahl für Modellintelligenz war und bleiben wird.“
Gleichzeitig verweist er auf ungleichmäßige Leistungsprofile. Unterschiedliche Modelle gewinnen unterschiedliche Tests, erklärt Hill-Smith. Artificial Analysis veröffentliche deshalb sämtliche Einzelergebnisse, aus denen sich der Index zusammensetzt, sowie weitere Resultate außerhalb der Gesamtwertung. Für Entwickler bedeutet das: Ob ein Modell für den eigenen Anwendungsfall geeignet ist, lässt sich anhand der jeweils relevanten Einzeltests genauer beurteilen als anhand eines Spitzenplatzes allein.
Adam D’Angelos Verbindung zu Artificial Analysis und OpenAI
Auch zur möglichen Einflussnahme bezieht Hill-Smith Stellung. Adam D’Angelo, Mitgründer und CEO der Frage-Antwort-Plattform Quora sowie früherer Technologiechef von Facebook, ist als Angel-Investor an Artificial Analysis beteiligt.
Zugleich sitzt D’Angelo im Board of Directors der OpenAI Foundation. Diese kontrolliert OpenAI und kann sämtliche Mitglieder des Verwaltungsrats der kommerziellen OpenAI Group bestellen und abberufen, wie das Unternehmen in seiner Darstellung der Führungsstruktur erläutert. Damit besteht eine personelle Verbindung zwischen der Bewertungsplattform und dem Unternehmen hinter GPT-6.
Hill-Smith weist eine Einflussnahme D’Angelos auf die beiden Updates ausdrücklich zurück: „Adam ist ein Angel-Investor bei Artificial Analysis. Er hatte keinen Einfluss auf diese Updates.“ Generell würden Geldgeber aus methodischen Entscheidungen herausgehalten: „Kein Investor hat jemals eine Entscheidung über die Benchmarking-Methodik beeinflusst, und wir beziehen Investor in keiner Weise in diese Entscheidungen ein.“
„OpenAI hat kein Feedback zu diesen Updates gegeben“
Die Frage nach Rückmeldungen von OpenAI beantwortet Hill-Smith ebenfalls konkret: „Ich kann ausdrücklich bestätigen, dass OpenAI kein Feedback gegeben hat, das mit den Upgrades auf v4.2 oder v4.3 zusammenhing.“ Die Entscheidungen seien ausschließlich von Artificial Analysis getroffen worden.
Zwar hole die Plattform regelmäßig Rückmeldungen von Unternehmen ein, die KI entwickeln oder einkaufen. Diese würden nach ihrem technischen Gehalt bewertet; über die Methodik entscheide Artificial Analysis selbst. Die dokumentierten Änderungen machen nachvollziehbar, was am Index umgebaut wurde. Die Aussagen über die internen Entscheidungswege bleiben die Darstellung des Unternehmens.
Version 5 soll Ende Oktober kommen
Der nächste größere Umbau ist bereits geplant. Für Index v5 peilt Artificial Analysis Ende Oktober an, wobei der Zeitplan nach den beiden vorgezogenen Updates noch angepasst werden könnte.
Eine Prognose zum Sieger gibt Hill-Smith ausdrücklich nicht ab: „Zum jetzigen Zeitpunkt habe ich keine Ahnung, ob GPT-6 auf Platz eins stehen wird.“ Interne, bisher unveröffentlichte Ergebnisse zeigten beeindruckende Fähigkeiten sowohl von Fable 5.1 als auch von GPT-6. Das Unternehmen werde weitere Benchmarks entwickeln und mit Partner zusammenarbeiten, um Fähigkeiten zu prüfen, die für Entwickler und Nutzer relevant seien.
Seine persönliche Einschätzung zum Wettbewerb fällt eindeutig aus: „Das KI-Rennen ist umkämpfter denn je, und ich selbst nutze diese Woche hauptsächlich sowohl GPT-6 als auch Fable 5.1.“