Huawei: Neue Ascend KI-Chips sollen nächste Generation der Open-Weight-Modelle rechnen
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
Auf der Huawei Connect in Shanghai hat der chinesische Konzern kürzlich seine nächste Generation an KI-Beschleunigern vorgezogen. Die Prozessoren Ascend 960DT und Ascend 960PR sollen im ersten und dritten Quartal 2027 verfügbar sein, rund drei Quartale früher als ursprünglich geplant. Dazu kommt mit dem Atlas 960E SuperPoD ein Rechensystem, das bis zu 4.096 dieser Chips zu einer Einheit verbindet.
Der Hintergrund: KI entwickelt sich von Anwendungen, die auf einzelne Eingaben reagieren, hin zu Agenten, die Aufgaben selbstständig planen und ausführen. Damit steigen Bedarf an Rechenleistung, Speicher und schnellen Netzwerken. Huawei beantwortet diesen Bedarf mit einem Systemansatz, der elf eigene Chips für Rechnen, Speicher, Netzwerk und Management umfasst und über den hauseigenen Interconnect UnifiedBus zusammengehalten wird.
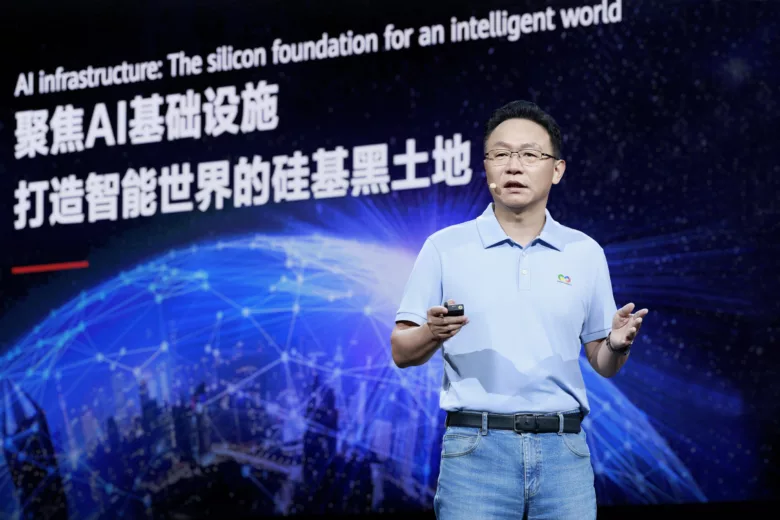
„Bei Huawei setzen wir uns dafür ein, leistungsstarke KI-Infrastrukturen aufzubauen und durch Open-Source- sowie offene Systemansätze Rechen-Ökosysteme zu entwickeln“, so David Wang, Rotating Chairman bei Huawei. „Wir werden weiterhin das native Training gängiger Basismodelle auf Ascend unterstützen und eine breite Palette an Modellen und Anwendungen aktiv fördern.“
Zwei Chips für zwei unterschiedliche Aufgaben
Huawei teilt die Generation in eine Trainings- und eine Inferenzvariante. Der Ascend 960DT, der ab dem ersten Quartal 2027 kommen soll, liefert nach Herstellerangaben 2 PFLOPS bei FP8 und 4 PFLOPS bei FP4. Er trägt 288 GB Hochleistungsspeicher mit 9,6 TB/s Bandbreite, die Verbindungsbandbreite zu anderen Chips liegt bei 2,2 TB/s. Der Speicher stammt aus Huaweis eigener HBM-Entwicklung, was angesichts der US-Exportbeschränkungen für Speicherchips ein zentraler Punkt der Roadmap ist.
Der Ascend 960PR folgt im dritten Quartal 2027 und ist auf Inferenz ausgelegt, also auf den laufenden Betrieb von Modellen. Er erreicht laut Tom’s Hardware ebenfalls 2 PFLOPS bei FP8, bei FP4 jedoch 8 PFLOPS, doppelt so viel wie in der ursprünglichen Planung angekündigt. Der Speicher fällt mit 192 GB und 2,4 TB/s kleiner und langsamer aus, was für Inferenzlasten mit kürzeren Kontexten ausreicht.
Dahinter liegt ein Jahresrhythmus: Für 2028 ist der Ascend 970 angekündigt, für 2029 der Ascend 980.
Ein Rechensystem aus 4.096 Prozessoren
Mit dem Atlas 960E SuperPoD stellte Huawei das dazugehörige System vor. Es verbindet bis zu 4.096 KI-Prozessoren so, dass sie für Software wie ein einziger großer Rechner erscheinen, inklusive gemeinsam adressierbarem Speicher. Huawei nennt 8 EFLOPS bei FP8 und bis zu ein Petabyte Hochleistungsspeicher. Gegenüber dem Vorgänger Atlas 950 gibt der Konzern die 2,3-fache Trainingsleistung, die 2,5-fache Inferenzleistung und um 70 Prozent geringere Latenzen an.
„Bei Huawei setzen wir uns dafür ein, leistungsstarke KI-Infrastrukturen aufzubauen und durch Open-Source- sowie offene Systemansätze Rechen-Ökosysteme zu entwickeln“, sagte David Wang, Rotating Chairman bei Huawei. Über 40 KI-Modelle seien bereits nativ auf Ascend-Hardware vortrainiert worden. Dass das in der Praxis funktioniert, zeigte zuletzt das Open-Source-Modell GLM-5, das ausschließlich auf chinesischen Huawei-Chips trainiert wurde.
Optik näher am Chip spart Strom
Damit tausende Prozessoren gemeinsam rechnen können, müssen sie sehr große Datenmengen untereinander austauschen. Huawei setzt dafür auf Near-Packaged Optics (NPO), bei der die optische Übertragung näher an den Prozessor rückt. Zum Einsatz kommen rund 5.500 neu entwickelte Hi-ONE-Einheiten mit je 7,2 Tbit/s. Herkömmlich wären dafür etwa 48.000 optische 800G-Module nötig.
Der Effekt: Der Strombedarf des Systems sinkt laut Huawei um mehr als 550 Kilowatt, die störungsfreie Betriebszeit verdoppelt sich, die Systemverfügbarkeit gibt der Konzern mit 99,8 Prozent an. Energieeffizienz ist für Huawei ein wichtiger Hebel, weil die Fertigung in China ohne modernste Belichtungstechnik auskommen muss und die Chips dadurch pro Rechenoperation mehr Strom brauchen als westliche Konkurrenzprodukte.
Der Vergleich mit Nvidia: auf Chip-Ebene deutlich dahinter
Die naheliegende Vergleichsgröße ist Nvidias Rubin-Generation, die zeitlich direkt vor Huaweis Ascend 960 liegt. Der Rubin-Beschleuniger R200, Kern der Plattform Vera Rubin, ist laut Tom’s Hardware das Gegenstück zum Ascend 960DT, der auf Kontextverarbeitung spezialisierte Rubin CPX das zum Ascend 960PR.
| Huawei Ascend 960DT | Huawei Ascend 960PR | Nvidia Rubin R200 | Nvidia Rubin CPX | |
|---|---|---|---|---|
| Ausrichtung | Training | Inferenz | Training und Inferenz | Inferenz, Kontextphase |
| Verfügbar ab | Q1 2027 | Q3 2027 | ab Q4 2026 | ab Q4 2026 |
| FP8 | 2 PFLOPS | 2 PFLOPS | ca. 16 PFLOPS | k. A. |
| FP4 | 4 PFLOPS | 8 PFLOPS | ca. 50 PFLOPS | ca. 30 PFLOPS |
| Speicher | 288 GB HBM | 192 GB HBM | 288 GB HBM4 | 128 GB GDDR7 |
| Speicherbandbreite | 9,6 TB/s | 2,4 TB/s | ca. 13 TB/s | k. A. |
| Chip-zu-Chip | 2,2 TB/s | 2,2 TB/s | 3,6 TB/s (NVLink 6) | in NVL144 CPX integriert |
Pro Chip ist der Abstand damit deutlich: Nvidia liefert bei FP8 rund das Achtfache und bei FP4 mehr als das Zehnfache eines Ascend 960DT, und das ein Jahr früher. Gleichauf liegen beide bei der Speicherkapazität, die darüber entscheidet, wie große Modellteile auf einen einzelnen Chip passen.
Auf Systemebene rückt Huawei näher heran
Genau deshalb argumentiert Huawei konsequent auf Systemebene. Dort fällt der Vergleich anders aus:
| Huawei Atlas 960E SuperPoD | Nvidia Vera Rubin NVL144 | Nvidia Rubin Ultra NVL576 | |
|---|---|---|---|
| Verfügbar ab | Q3 2027 | ab Q4 2026 | H2 2027 |
| Anzahl Recheneinheiten | 4.096 NPUs | 144 GPU-Dies (72 Packages) | 576 GPU-Dies (144 Packages) |
| FP8 | 8 EFLOPS | k. A. | k. A. |
| FP4 | ca. 16 EFLOPS | ca. 3,6 EFLOPS | ca. 14,4 EFLOPS |
| Speicher im Verbund | bis zu 1 PB HBM | ca. 20,7 TB HBM4 | ca. 144 TB HBM4e |
| Leistungsaufnahme | k. A. | k. A. | ca. 600 kW |
Auf dieser Ebene liegen die Systeme in derselben Größenordnung. Der Preis dafür ist allerdings die Stückzahl: Huawei braucht für vergleichbare Gesamtleistung ein Vielfaches an Chips, Racks, Stellfläche und Energie. Die Stärke liegt im Interconnect und in der Fähigkeit, sehr viele schwächere Einheiten effizient zu koppeln. Diesen Ansatz verfolgt der Konzern schon seit dem Atlas-950-System, mit dem Huawei den Markt für KI-Supercomputer angreifen will.
DeepSeek als Gradmesser
Wie weit Huawei tatsächlich gekommen ist, lässt sich gut am prominentesten chinesischen Kunden ablesen. DeepSeek hat für ein Rechenzentrum in Ulanqab in der Inneren Mongolei nach Medienberichten mindestens 160.000 Ascend-950DT-Chips geordert. Beim jüngsten Modell V4 und dem darauf folgenden V4-Pro sagte Huawei „volle Unterstützung“ zu: Die gesamte Ascend-SuperNode-Produktlinie sei zum Marktstart für die Inferenz angepasst gewesen.
Genau hier liegt der Unterschied. Der Großauftrag und die Anpassungsarbeit betreffen den laufenden Betrieb der Modelle. Trainiert hat DeepSeek seine Modelle bislang weiter auf Nvidia-Hardware, nachdem ein früherer Versuch, das Modell R2 auf Ascend-Chips zu trainieren, an Stabilitätsproblemen im verteilten Training scheiterte und zu Verzögerungen führte. Der Ascend 960DT ist Huaweis Antwort darauf, und ob chinesische Labore ihre Spitzenmodelle künftig komplett im Inland trainieren, wird sich an dieser Generation entscheiden. Dass es grundsätzlich geht, hat zuletzt Zhipu AI mit GLM-5 gezeigt.
Einzuordnen ist außerdem, dass sämtliche genannten Werte Herstellerangaben und theoretische Spitzenwerte sind. Unabhängige Benchmarks liegen für keine der beiden Generationen vor, und die tatsächlich erzielbare Auslastung hängt stark von Software, Modellarchitektur und Netzwerk ab. Hinzu kommt der Ökosystem-Faktor: Nvidias CUDA ist der De-facto-Standard, während Huaweis CANN-Plattform erst aufholt. Der Konzern gibt an, dass inzwischen 61 Prozent der CANN-Beiträge von externen Entwickler:innen stammen und über 90 Open-Source-Projekte unterstützt werden, darunter PyTorch, vLLM und Triton.
Praktisch relevant bleibt auch die Fertigung. Analyst:innen sehen die Stückzahl an verfügbarem Hochleistungsspeicher als den engsten Flaschenhals für Huaweis Ascend-Hochlauf, nicht die Logikfertigung allein.
Huawei rechnet mit hunderttausendfachem Token-Bedarf
Wie stark der Bedarf steigen könnte, beschreibt Huawei im parallel veröffentlichten Report „Intelligent World 2035: Turning Vision into Action“. Demnach könnte die weltweite jährliche Verarbeitung von KI-Tokens bis 2035 um das 100.000-Fache steigen, mehr als 90 Prozent des Datenverkehrs könnten auf KI-Agenten entfallen. Der Report nennt zehn Entwicklungsfelder, von zunehmend autonomer KI über neue Rechen-, Speicher- und Netzwerktechnik bis zu Endgeräten, autonomem Fahren, Energieversorgung und Datenschutz.
Der gemeinsam mit dem Institute of Economics der Tsinghua University erstellte Global Digitalization and Intelligence Index 2026 beziffert den kumulierten wirtschaftlichen Wert von KI in den kommenden fünf Jahren auf mehr als 27 Billionen US-Dollar. Die weltweiten Investitionen in digitale und intelligente Infrastruktur könnten bis 2030 auf mehr als vier Billionen US-Dollar steigen.