Jev: Warum dieses neuartige KI-Modell gerade Entwicker:innen begeistert
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
Ein Start-up aus San Francisco hat vergangene Woche ein KI-Modell veröffentlicht, das mit Menschen gar nicht reden will. Jev heißt es, es kommt von TypeSafe AI, und in den Tagen seit dem Launch ist es zum meistdiskutierten Modell in der Developer-Community geworden. Der Andrang war so groß, dass die API des Unternehmens zeitweise keine Anfragen mehr bedienen konnte.
Was Jev eigentlich macht
Große Sprachmodelle erzeugen Text: Token für Token, jedes abhängig vom vorherigen. Jev arbeitet anders. Entwickler:innen definieren vorab ein Schema, also eine Struktur möglicher Antworten, und schicken einen unstrukturierten Zustand hinein: eine Support-Anfrage, einen Log-Eintrag, einen Spielstand. Zurück kommen typisierte Werte samt Wahrscheinlichkeiten, die eine Software direkt weiterverarbeiten kann. TypeSafe nennt das „calibrated decisions“, kalibrierte Entscheidungen, und beschreibt das Modell in seinem Launch-Blogpost als „frontier-intelligence function call“.
Der Name der Modellklasse, System One Models, ist von Daniel Kahnemans „Schnelles Denken, langsames Denken“ entlehnt: schnelle, intuitive Einschätzungen statt langer Denkketten. Der Modellname geht auf den Ökonomen William Stanley Jevons zurück, dessen Paradoxon beschreibt, wie sinkende Kosten einer Ressource deren Verbrauch steigen lassen.
Ein typischer Anwendungsfall aus der TypeSafe-Dokumentation ist das Routing im Kundendienst: Jev entscheidet, ob eine eingehende Anfrage an normalen Programmcode, an ein Sprachmodell oder an einen Menschen geht. Weitere Einsatzgebiete, die das Unternehmen nennt, sind Werkzeugauswahl für KI-Agenten, Guardrails, die Ein- und Ausgaben anderer Modelle prüfen, sowie Klassifikation über sehr große Datenmengen.
Wer dahintersteckt
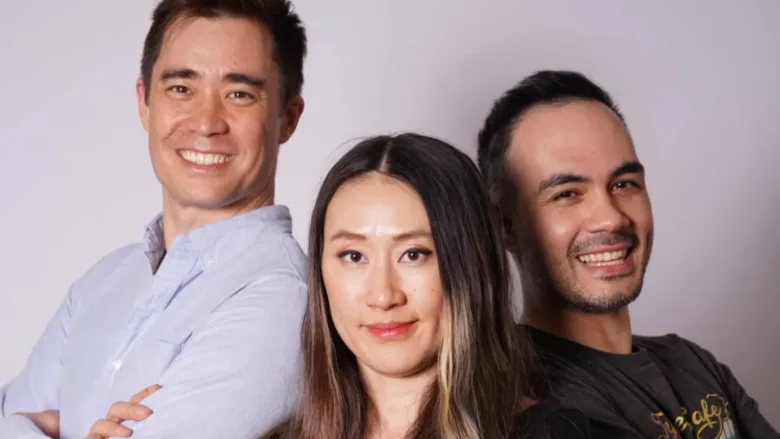
Gegründet wurde TypeSafe AI 2024 von Diogo Almeida, davor Forscher bei OpenAI und Mitautor der InstructGPT-Arbeit, die eine der Grundlagen für ChatGPT bildete. Almeida hat an Reinforcement Learning from Human Feedback (RLHF) mitgearbeitet, jener Trainingsmethode, die den heutigen Chatbot-Boom erst möglich gemacht hat. Seine Motivation für die Neugründung beschreibt er gegenüber TechCrunch drastisch: „Wir haben den Blitz in der Flasche, und trotzdem ist er nicht nützlich.“ Sprachmodelle seien seit Jahren extrem gut in menschlicher Sprache, für Automatisierung aber wenig brauchbar, weil Computer eine andere Sprache sprechen.
Als Co-Founder sind Erik Gafni und Sasha Sheng an Bord. Nach rund zwei Jahren im Stealth-Modus kam das Unternehmen gleichzeitig mit dem Modell-Launch aus der Deckung und gab eine Seed-Runde über 40 Millionen Dollar (rund 34 Millionen Euro) bekannt, angeführt von DCVC. Forbes berichtete dabei von einer Bewertung um 200 Millionen Dollar (rund 171 Millionen Euro), wie SiliconANGLE zusammenfasst.
Warum die Szene so begeistert reagiert
Drei Punkte treiben den Hype. Erstens das Tempo: TypeSafe gibt Antwortzeiten von 70 bis 500 Millisekunden an, weil alle Ausgaben parallel in einer einzigen Abfrage erzeugt werden. Bei Frontier-Modellen liegen die Antwortzeiten laut Unternehmen zwischen 3 und 329 Sekunden.
Zweitens der Preis: Input kostet 0,042 Dollar pro Million Token (rund 0,036 Euro), Output-Token stellt TypeSafe gar nicht in Rechnung. Ein Demo-Bot, der das Videospiel Doom mit zehn Abfragen pro Sekunde steuert, kommt damit auf etwa 7 Dollar (rund 6 Euro) pro Stunde, ein Kunststück, über das auch The Register schrieb.
Drittens die Verlässlichkeit der Form: Weil das Ausgabeschema vorab feststeht, sind Typfehler ausgeschlossen, und halluzinierte Werkzeugaufrufe oder erfundene Kategorien fallen weg. Erste Praxisberichte klingen entsprechend euphorisch. Ein Vercel-Engineer ersetzte ein OpenAI-Modell in einem Sicherheits-Klassifikator und berichtet von fünf- bis 18-fach schnelleren Ergebnissen bei höherer Treffsicherheit. Ein anderer Entwickler testete Jev gegen Gemini bei der Klassifikation von Geschäfts-E-Mails: Gemini war leicht genauer, aber zehn- bis zwanzigmal teurer.
Besonders geschätzt werden die mitgelieferten Konfidenzwerte. Armin Ronacher, CTO von Earendil, formuliert den Effekt gegenüber TechCrunch nüchtern: Das Modell delegiere das Halluzinationsproblem ein Stück weit an die Nutzer:innen, die nun selbst entscheiden müssten, ab welcher Wahrscheinlichkeit sie einer Antwort vertrauen. Ronacher sieht auch Model-Routing als Anwendungsfall und erwartet, dass rasch Konkurrenz entstehen wird.
Was offenbleibt
Die beeindruckendsten Zahlen stammen bislang vom Anbieter selbst. TypeSafe hat eigene Workflow-Evaluationen veröffentlicht und legt die Methodik offen, verwendet als Referenz für korrekte Antworten allerdings den Durchschnitt der Ausgaben von GPT-6 Astra und Claude Fable 5.1. Das Unternehmen räumt selbst ein, dass dieser Ansatz die Ergebnisse in Richtung der großen US-Labore verzerrt und dass die Workflows von den eigenen Teams erstellt wurden. Unabhängige Überprüfungen stehen aus, und die Werte dürften je nach Workload, Netzwerkstandort und Vergleichsmethode stark schwanken.
Auch inhaltlich gibt es Einschränkungen. Die Schema-Treue garantiert die Form einer Antwort, über deren sachliche Richtigkeit sagt sie nichts aus. Wie gut die Konfidenzwerte mit der tatsächlichen Trefferquote übereinstimmen, müssen Anwender:innen auf ihren eigenen Daten prüfen. Jev unterstützt zudem nur Auswahlmengen bis zu einer Kardinalität von 255, größere Entscheidungsräume erfordern zweistufige Verfahren. Für Bilder und andere Modalitäten ist das Modell bislang nicht ausgelegt.
Dazu kommt eine Transparenzfrage, auf die heise online hinweist: Jev liefert keine sprachliche Begründung für seine Entscheidungen. Je tiefer solche Modelle in Software eingebaut werden, desto wichtiger wird die Frage, wie sich ihr Verhalten nachvollziehen und kontrollieren lässt.
Offen ist schließlich auch die Architektur. Almeida hält sich dazu bedeckt, externe Beobachter:innen vermuten ein Open-Weight-Sprachmodell als Basis. Trainiert wurde Jev nach Angaben des Unternehmens ausschließlich auf synthetischen Daten. Ob die aggressive Preisgestaltung ohne Quersubventionierung tragfähig ist, wird sich erst über längere Zeit zeigen. TypeSafe selbst schreibt dazu, man könne nicht beweisen, dass die Preise nicht subventioniert seien.
Jev ist aktuell im Early Access über eine gehostete API verfügbar, das Unternehmen arbeitet die Warteliste ab und kündigt weitere Modelle in zusätzlichen Modalitäten an.