Fable 5.1: Das neue beste KI-Modell ist wieder einmal teurer
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
Anthropic hat soeben Claude Fable 5.1 vorgestellt, gemeinsam mit dem baugleichen Schwestermodell Claude Mythos 5.1, das nur über Programme für geprüfte Organisationen zugänglich ist. Fable 5.1 setzt sich in den Messungen des Analysehauses Artificial Analysis an die Spitze aller bisher getesteten Modelle. Auffällig ist dabei eine Diskrepanz zwischen dem, was Anthropic beim Preis in Aussicht stellt, und dem, was Artificial Analysis tatsächlich abgerechnet hat. Anthropic senkt die Kosten für Cache-Reads um 75 Prozent und beziffert die Ersparnis für typische Workloads mit rund 25 Prozent gegenüber dem Vorgänger, bei stark agentischen Aufgaben mit bis zu etwa 45 Prozent. In den Messungen von Artificial Analysis kostet eine Aufgabe mit Fable 5.1 dagegen rund 20 Prozent mehr als mit Fable 5, weil das neue Modell deutlich mehr Tokens verbraucht. Die Preissenkung dämpft den Anstieg, dreht ihn aber nicht um.
Höchster je gemessener Wert im Intelligence Index
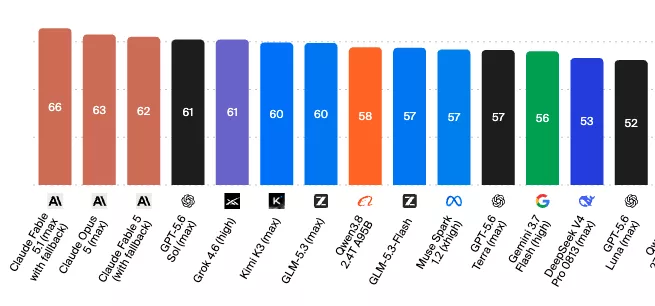
Artificial Analysis, das Anthropic bereits vor dem Launch bei der Evaluierung unterstützt hat, misst für Fable 5.1 auf der höchsten Reasoning-Stufe („max“) 66 Punkte im Artificial Analysis Intelligence Index. Das ist laut den Analyst:innen der höchste jemals erfasste Wert, vor Claude Opus 5 (63), Claude Fable 5 (62) sowie GPT-5.6 Sol und Grok 4.6 (je 61). Gegenüber Fable 5 sind das vier Punkte mehr.
Auch in den Einzeldisziplinen sammelt das Modell Bestwerte: In „Humanity’s Last Exam“ kommt es auf 59,1 Prozent gegenüber zuvor 55,5 Prozent, bei Terminal-Bench v2.1 auf 91,4 Prozent und bei SciCode auf 62,0 Prozent. Im Banking-Szenario 𝜏³ legt es neun Punkte gegenüber Fable 5 zu. Anthropic selbst weist für agentische Wissenschaftsaufgaben (Terminal-Bench-Science 0.1) einen Sprung von 24,7 auf 52,6 Prozent aus. Bei den Tests von Artificial Analysis wurde die serverseitige Rückfalloption von Anthropic mitgetestet, die sicherheitsmarkierte Anfragen an Claude Opus 4.8 oder Opus 5 weiterreicht. Dieser Fallback bearbeitete etwa vier Prozent der Output-Tokens.
Günstigere Cache-Reads, teurere Aufgaben
Anthropic senkt mit dem Launch den Preis für Cache-Reads, also für bereits verarbeitete und zwischengespeicherte Eingaben, von einem US-Dollar auf 0,25 Dollar je Million Tokens. Die übrigen Preise bleiben unverändert bei 10 Dollar für eine Million Input-Tokens, 50 Dollar für eine Million Output-Tokens und 12,50 Dollar für Cache-Writes. Auf dieser Basis kommt Anthropic auf die genannten 25 Prozent Ersparnis für typische Workloads und bis zu 45 Prozent bei stark agentischen Aufgaben.
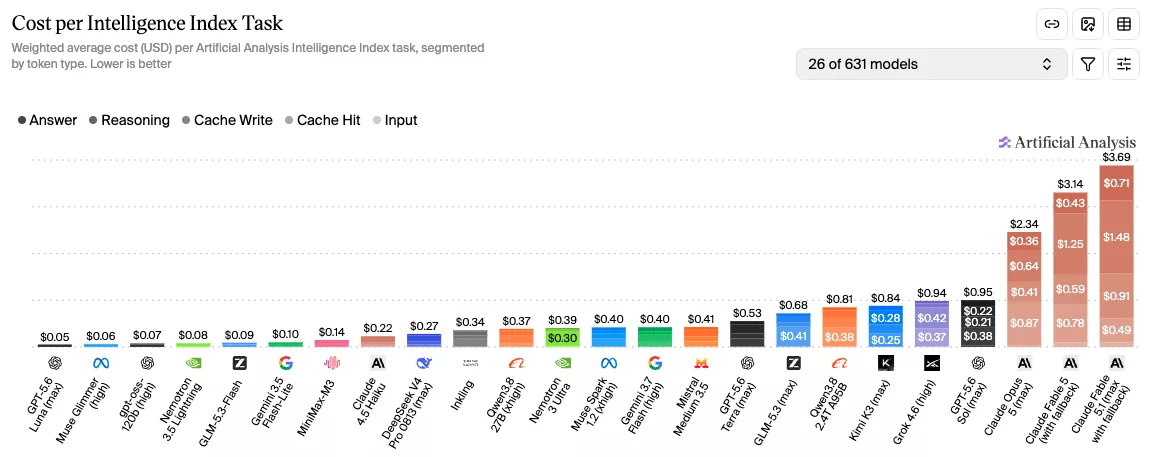
Die Rechnung von Artificial Analysis fällt anders aus, weil sie den gestiegenen Token-Verbrauch einbezieht. Eine Aufgabe im Intelligence Index kostet mit Fable 5.1 auf max-Stufe 3,76 Dollar, mit Fable 5 waren es 3,14 Dollar. Das sind 20 Prozent mehr und das 1,6-Fache von Claude Opus 5 (2,34 Dollar). Grund ist der rund 1,7-fache Output-Token-Verbrauch. Die Preissenkung bei den Cache-Reads spart dabei etwa 1,40 Dollar pro Aufgabe ein, vor allem in den agentischen Tests, wo der Großteil der Eingaben aus Cache-Reads besteht. Ohne die Senkung läge der Preis bei etwa 5,16 Dollar.
Wer bereit ist, einen Punkt Leistung zu opfern, fährt günstiger: Auf der Stufe „xhigh“ erreicht Fable 5.1 noch 65 Punkte und kostet 2,72 Dollar pro Aufgabe, also 1,04 Dollar weniger als auf max-Stufe. Insgesamt bietet Anthropic fünf Effort-Stufen an, die im Test zwischen 58 und 66 Punkten liegen und deren Token-Verbrauch um den Faktor elf auseinanderklafft (13,1 Millionen bis 143,7 Millionen Output-Tokens). Der Einstiegsverbrauch liegt damit etwas höher als bei der Konkurrenz: GPT-5.6 Sol auf mittlerer Stufe kommt mit 12 Millionen Tokens aus.
Bei Wissensarbeit praktisch gleichauf mit Opus 5
In den agentischen Wissensarbeits-Tests von Artificial Analysis setzt Fable 5.1 zwar Bestmarken (1.853 Elo bei GDPval-AA v2, 1.694 bei AA-Briefcase), der Abstand zu Claude Opus 5 liegt aber innerhalb der statistischen Unschärfe beziehungsweise gleichauf (1.824 respektive 1.685). Die Stärken verteilen sich unterschiedlich: Fable 5.1 liegt bei analytischer Qualität vorn, bei der Präsentation der Ergebnisse hinten.
Bemerkenswert ist auch das Verhalten bei Wissensfragen. Fable 5.1 beantwortet im Test AA-Omniscience 93,4 Prozent der Fragen (Opus 5: 87,8 Prozent) und erreicht mit 67,2 Prozent die höchste je gemessene Trefferquote. Zugleich halluziniert es häufiger: Von den nicht korrekt beantworteten Fragen versuchte es sich an 72,6 Prozent, bei Fable 5 waren es 63,6 Prozent. Beide Effekte heben einander auf, der Omniscience-Index bleibt auf dem Niveau des Vorgängers.
Kontextfenster, Safeguards und Verfügbarkeit
Das Kontextfenster liegt weiterhin bei einer Million Tokens, verarbeitet werden Text und Bilder. Parallel zum Modell führt Anthropic „Enterprise Frontier Safeguards“ ein, bei denen Kund:innen ihre Daten in der eigenen Cloud-Infrastruktur behalten und eine allfällige menschliche Prüfung selbst übernehmen. Der Rollout startet schrittweise, bis dahin können berechtigte Unternehmen Fable 5.1 ohne Datenspeicherung nutzen. Bei den Sicherheitsfiltern meldet Anthropic deutlich weniger Fehlalarme: Im Bereich Cybersecurity sollen rund 60 Prozent weniger harmlose Anfragen blockiert werden, das Aufspüren von Software-Schwachstellen ist nun erlaubt, das Entwickeln von Exploits weiterhin nicht. Anfragen aus der Life-Science-Forschung werden weiter an die Opus-Modelle umgeleitet.
Fable 5.1 ist ab sofort über die Claude API sowie über Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. In Claude Code arbeitet das Modell standardmäßig auf „High“-Stufe, in Claude Cowork und auf claude.ai auf „Medium“.
Nicht enthalten ist das neue Modell im Pauschalpreis der Claude-Abos: Wer Claude Pro nutzt, muss die Verwendung von Fable 5.1 extra bezahlen. Das beste im Abo inkludierte Modell bleibt damit Claude Opus 5. Für Abonnent:innen relevant ist das vor allem deshalb, weil Opus 5 laut den Messungen von Artificial Analysis bei agentischer Wissensarbeit ohnehin nahe an Fable 5.1 herankommt und pro Aufgabe günstiger bleibt.