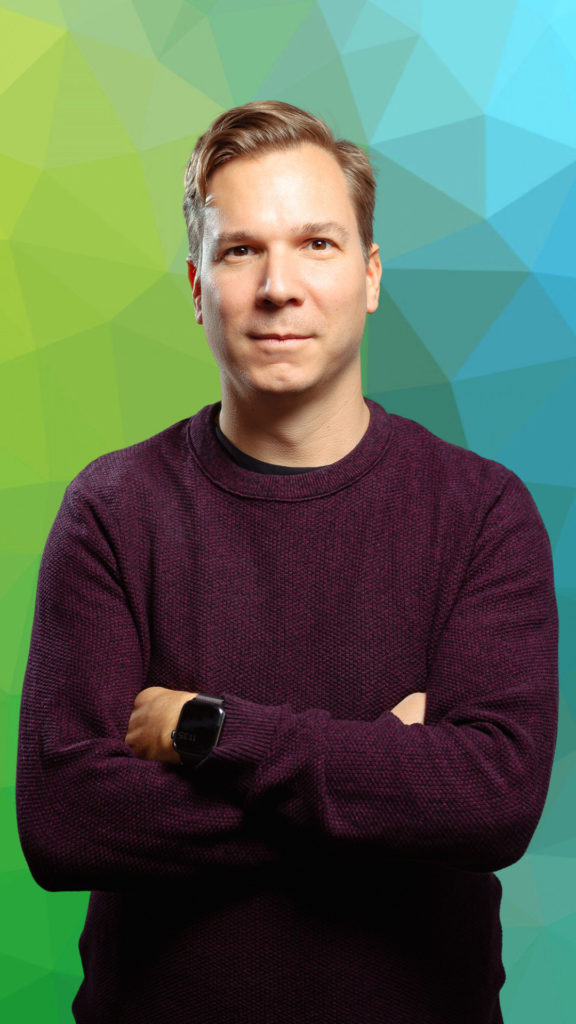
Vergiss AGI, hier kommt RSI! Z.ai sagt, GLM habe eigene Inferenz-Infrastruktur gebaut
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
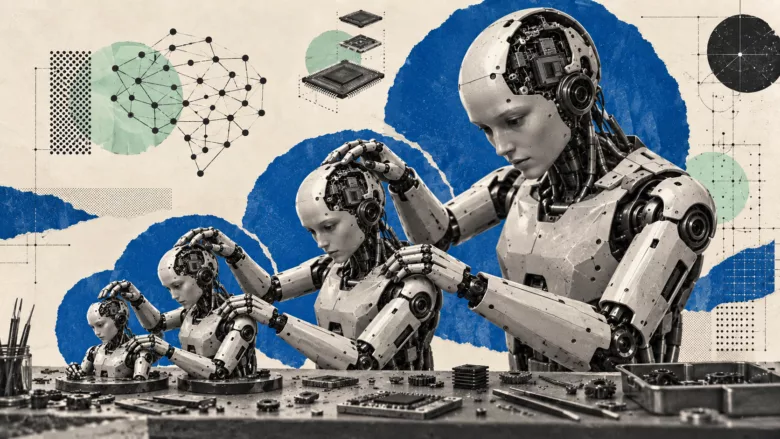
Jahrelang drehte sich die Debatte in der KI-Branche um AGI, also um eine künstliche allgemeine Intelligenz. Jetzt rückt ein anderes Kürzel in den Vordergrund: RSI, kurz für Recursive Self-Improvement. Gemeint ist ein KI-System, das an seiner eigenen Weiterentwicklung mitarbeitet, bis es im Extremfall seinen Nachfolger selbstständig entwirft und trainiert.
Das chinesische KI-Unternehmen Z.ai (vormals Zhipu AI) hat soeben in einem ausführlichen Forschungsbeitrag beschrieben, wie sein Modell GLM-5.3 maßgeblich jene Infrastruktur gebaut haben soll, auf der eine Variante des Modells heute läuft.
Der Schlüsselsatz des Beitrags lautet: „The model optimizes the system; the system runs the model.“ Das Modell optimiert also das System, und das System betreibt wiederum das Modell.
Über 100.000 chinesische KI-Chips
Konkret geht es um GLM-5.3-Flash. Laut Z.ai wurde dafür ein produktionsreifer Inferenz-Dienst von Grund auf neu aufgebaut, und zwar auf einem Cluster aus mehr als 100.000 KI-Beschleunigern aus chinesischer Produktion. Sämtliche produktiven Anfragen an GLM-5.3-Flash sollen über dieses System laufen. Einen Cluster chinesischer Chips in dieser Größenordnung habe zuvor noch niemand betrieben, schreibt das Unternehmen.
Die Hürden waren demnach beträchtlich: vergleichsweise wenig Chip-Speicher und Bandbreite, eine neue Modellarchitektur, ein Kontextfenster von einer Million Tokens sowie multimodale Anfragen. Das Ökosystem sei unausgereift gewesen, die Kernel-Unterstützung lückenhaft, und vieles, was eigentlich dokumentiert sein sollte, habe man erraten müssen. Einen großen Teil der Arbeit habe ein sogenannter Infra Agent erledigt, der auf GLM-5.3 basiert.
Das Ergebnis laut Z.ai: Von der ersten Anpassung des Modells bis zur Produktionsreife vergingen weniger als zwei Wochen. Der End-to-End-Durchsatz habe sich gegenüber dem Ausgangswert rund verdreifacht, Hardware-Effizienz und Kosten pro Token lägen auf einem Niveau, das mit gängigen Nvidia-GPUs vergleichbar sei. Getestet wurde das Modell zuvor anonym unter dem Namen Ox-Alpha auf OpenCode und OpenRouter, wo es binnen einer Woche zum meistgenutzten Modell auf beiden Plattformen geworden sein soll, mit mehr als 62 Billionen verarbeiteten Tokens in sechs Tagen. Z.ai hat inzwischen bestätigt, hinter Ox-Alpha zu stehen.
„Dichtes Feedback“ als Schlüssel
Den Kern des Beitrags bildet ein Konzept, das Z.ai „Dense Feedback“ nennt. Die Grundidee: Ein Agent kann mit groben Messwerten wie „Durchsatz um 20 Prozent gesunken“ wenig anfangen, weil sie nicht verraten, welche Schicht des Systems verantwortlich ist. Z.ai hat deshalb Korrektheitstests, Laufzeit-Logs, Ausführungs-Traces, Mikro-Benchmarks und End-to-End-Metriken so in den Arbeitsablauf des Agenten eingebunden, dass er Hypothesen lokal, schnell und überprüfbar testen kann.
Die Aufgabenteilung beschreibt das Unternehmen so: Ingenieur:innen legen Ziele und Systemgrenzen fest und prüfen kritische Änderungen, der Agent übernimmt Analyse, Hypothesenbildung und Code-Änderungen, und die Testumgebung liefert die Rückmeldungen.
Drei Beispiele sollen das illustrieren:
- Rechenfehler: Der Agent fand einen Genauigkeitsfehler im Context-Parallelism-Pfad des KDA-Kernels, der sich bei langen Kontexten verstärkte. Die Korrektur wurde laut Z.ai in das Open-Source-Projekt Flash Linear Attention übernommen.
- Engpass bei der Parallelität: Beim Zusammenspiel von DeepEP und Mooncake Transfer blockierte der Python-GIL die KV-Übertragung. Nach der Korrektur sank der Leistungsabstand zwischen den Testszenarien von über 20 auf unter ein Prozent.
- Kernel-Optimierung: Der Agent extrahierte Optimierungstechniken aus bestehenden Projekten wie SGLang oder DeepGEMM, destillierte sie zu wiederverwendbaren „Optimierungsskeletten“ und erzielte bei einem Decode-Kernel eine Beschleunigung um den Faktor 1,71.
Z.ai relativiert selbst
Trotz der großen Überschrift bleibt Z.ai in seiner Einordnung vorsichtig. Man habe RSI noch nicht erreicht, schreibt das Unternehmen, es zeigten sich aber frühe Formen davon. Ziele zu wählen, Grenzen zu setzen und Risiken abzuwägen, bleibe Aufgabe von Menschen, und das solle auch noch lange so bleiben. Zugleich heißt es, GLM-5.3 sei inzwischen für das gesamte Team ein unverzichtbarer Coding-Partner und bewege sich „stetig darauf zu, uns zu ersetzen“.
Unabhängig überprüfen lassen sich die Angaben derzeit kaum. Die Zahlen zu Durchsatz, Entwicklungsdauer und Clustergröße stammen ausschließlich vom Unternehmen selbst, und wie groß der Anteil des Agenten im Vergleich zu den beteiligten Ingenieur:innen tatsächlich war, geht aus dem Beitrag nicht exakt hervor. Nachprüfbar ist vor allem der öffentlich eingereichte Code-Beitrag zu Flash Linear Attention.
Bemerkenswert ist der Beitrag auch vor dem Hintergrund, dass Z.ai zuletzt vor allem mit Cybersecurity-Fähigkeiten seiner Modelle auf sich aufmerksam machte. GLM-5.2 soll hier mit Anthropics Mythos mithalten, und im aktuellen Text schreibt das Unternehmen, Sicherheitspartner:innen hätten mit GLM Tausende Schwachstellen in realen Codebasen gefunden.
Auch Google soll RSI erreicht haben
Z.ai ist mit dem Thema nicht allein. Auch um Google, bei dem es in Sachen neuer KI-Modelle zuletzt etwas ruhiger geworden ist, kursiert kürzlich das Gerücht, RSI erreicht zu haben. Ausgangspunkt war ein kryptischer Post des KI-Leak-Accounts „Lyra“, der Google DeepMind mit den Worten „huge congRatulationS Indeed!“ gratulierte, wobei die Großbuchstaben das Kürzel RSI ergeben. Eine Bestätigung von Google gibt es nicht, und der Post nannte weder Modell noch Forschungsergebnis oder Benchmark, wie Zeniteq festhält.
Dass Google intensiv an selbstverbessernden Systemen arbeitet, gilt allerdings als gesichert. Laut Reuters hat der Konzern seine KI-Führung umgebaut, Mitgründer Sergey Brin soll intern darauf drängen, DeepMind stärker in Richtung Recursive Self-Improvement auszurichten. Googles System AlphaEvolve hat bereits einen Kernel für das Training der hauseigenen Modelle beschleunigt und so die Trainingszeit leicht verkürzt. Ob aus diesen frühen Rückkopplungsschleifen tatsächlich ein sich selbst beschleunigender Kreislauf wird, bleibt vorerst offen, bei Google ebenso wie bei Z.ai.