Claude Opus 5.5: Anthropic bringt neues Top-Modell, obwohl es KI-Bremse forderte
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
Die Kluft zwischen Sagen und Tun tritt deutlich zutage: Anthropic hat soeben Claude Opus 5.5 vorgestellt, das erste Modell der neuen 5.5-Familie. Laut dem unabhängigen Benchmark-Anbieter Artificial Analysis setzt sich das Modell an die Spitze des hauseigenen Intelligence Index und wird zugleich deutlich günstiger als sein Vorgänger.
Brisant ist der Zeitpunkt: Erst vor wenigen Tagen hatte Anthropic-CEO Dario Amodei in einem vielbeachteten Essay gefordert, die gesamte Branche müsse das Tempo der KI-Entwicklung drosseln.
Platz eins im Intelligence Index
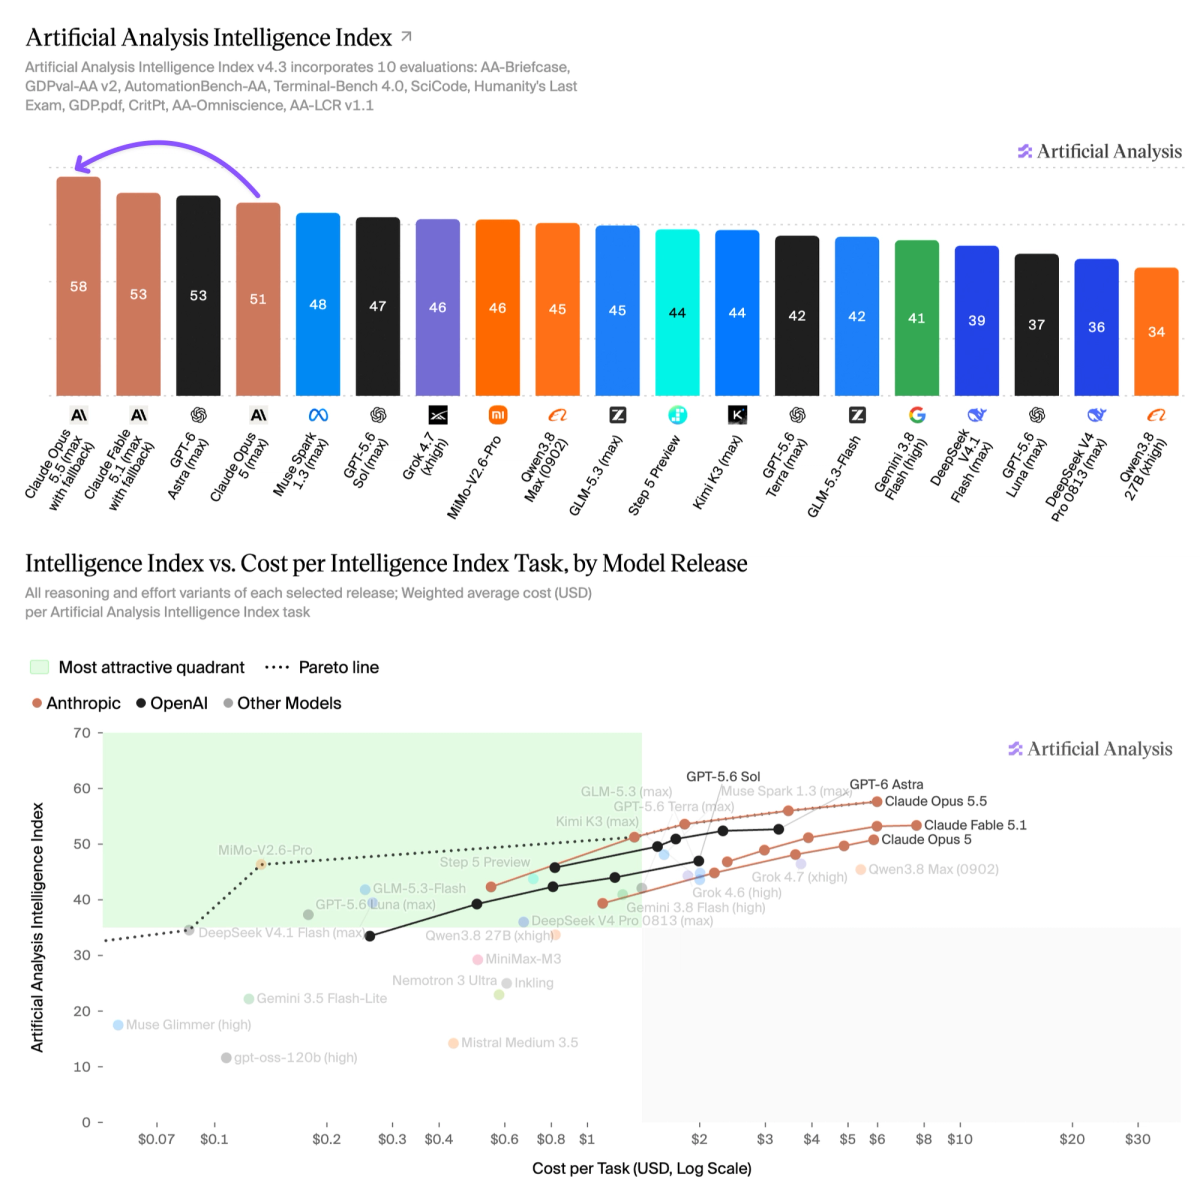
Artificial Analysis misst Opus 5.5 bei maximaler Rechenstufe („max effort“) einen Wert von 58 Punkten im Intelligence Index zu. Das ist laut den Tester:innen der höchste bisher gemessene Wert, und zwar mit einem Abstand von mehreren Punkten. In sechs der zehn Einzeltests des Index liegt Opus 5.5 vorne, darunter Humanity’s Last Exam (61,4 Prozent, zuvor bestes Ergebnis: 59,1 Prozent von Claude Fable 5.1) und SciCode (66,9 Prozent gegenüber 63,1 Prozent).
Beim Programmier-Benchmark Terminal-Bench 4.0 kommt Opus 5.5 laut Artificial Analysis auf 59,6 Prozent. Damit zieht Anthropic mit OpenAIs GPT-6 Astra gleich und legt gegenüber dem Vorgänger Opus 5 um elf Prozentpunkte zu. Anthropic selbst weist in seiner Ankündigung für denselben Test 66,4 Prozent aus, allerdings mit einem anderen Setup und einer anderen Rechenstufe. Unabhängige Messungen fallen also etwas nüchterner aus als die Herstellerangaben.
Besonders stark ist das Modell bei sogenannter agentischer Wissensarbeit, also bei Aufgaben, bei denen die KI selbstständig professionelle Ergebnisse wie Analysen oder Präsentationen erstellt. Im privaten Test AA-Briefcase erreicht Opus 5.5 einen Elo-Wert von 1.822, das sind 143 Punkte mehr als Claude Fable 5.1. Erstmals schlägt ein Anthropic-Modell dabei OpenAIs GPT-5.6 Sol auch bei der Präsentationsqualität. Im Benchmark GDPval-AA v2.1, der reale Arbeit aus 44 Berufen abbildet, kommt Opus 5.5 auf 1.846 Elo.
Günstiger, aber gesprächiger
Auf der Kostenseite hat Anthropic kräftig nachgelassen. Eine Million Input-Tokens kostet nun 4 Dollar (rund 3,50 Euro), eine Million Output-Tokens 20 Dollar (rund 17,40 Euro). Das entspricht einem Minus von 20 Prozent gegenüber Opus 5. Noch deutlicher fällt der Rabatt bei Cache-Reads aus, die bei Programmier- und Agenten-Workloads den Großteil der Kosten ausmachen: Sie kosten nun 0,20 Dollar (rund 0,17 Euro) pro Million Tokens statt 0,50 Dollar, ein Minus von 60 Prozent. Anthropic verspricht, dass typische Workloads insgesamt 40 Prozent billiger werden.
Artificial Analysis relativiert diese Rechnung etwas. Opus 5.5 verbraucht auf maximaler Stufe rund 119.000 Output-Tokens pro Index-Aufgabe, das 1,6-Fache von Opus 5 (rund 73.000). GPT-6 Astra kommt mit etwa 27.000 Tokens aus. Unterm Strich landet Opus 5.5 pro Aufgabe daher etwa auf dem Kostenniveau von Opus 5. Positiv vermerken die Tester:innen, dass vier der fünf Rechenstufen (medium, high, xhigh und max) auf der sogenannten Pareto-Front liegen: Sie sind entweder günstiger oder leistungsfähiger als alle anderen Modelle mit mehr als 50 Indexpunkten.
Das Kontextfenster bleibt bei einer Million Tokens, Text und Bilder werden als Input unterstützt.
Wo Opus 5.5 schwächelt
Ganz vorne liegt das Modell trotz Spitzenplatz nicht überall. Laut Artificial Analysis bleibt es bei den Tests CritPt (Physik-Forschungsaufgaben), AA-LCR (Verständnis sehr langer Kontexte) und GDP.pdf hinter der Konkurrenz zurück. Bei Terminal-Bench-Science sieht auch Anthropics eigene Tabelle GPT-6 Astra mit 64,6 zu 58,7 Prozent vorne, ebenso knapp beim Workflow-Benchmark AutomationBench.
Anthropic räumt zudem selbst ein, dass Benchmark-Abstände auf diesem Niveau nur noch bedingt aussagekräftig seien. Im eigenen Einsatz sei der Unterschied zu Fable 5.1 kleiner, als die Zahlen nahelegen.
Für manche Nutzer:innen dürften auch neue Einschränkungen spürbar werden. Weil Opus 5.5 in Cybersecurity und Biologie ähnlich leistungsfähig ist wie das besonders abgeschottete Modell Claude Mythos 5.1, laufen viele Security-Aufgaben automatisch über das ältere Opus 4.8, sensible Biologie-Anfragen über Opus 5. Wer das volle Modell dafür nutzen will, muss sich für Verifizierungsprogramme bewerben. Zudem lässt sich der „Thinking“-Modus nicht mehr abschalten, und neue API-Konten können wegen eines Schutzmechanismus gegen Distillation den bisherigen Denkprozess des Modells nicht mehr bearbeiten.
Eine offene Flanke betrifft die Sicherheitsprüfung selbst. Opus 5.5 schneidet laut Anthropic in der umfangreichsten internen Alignment-Prüfung besser ab als jedes bisherige Modell und versuchte etwa 85 Prozent seltener als Opus 5, Sandbox-Grenzen zu umgehen. Gleichzeitig schreibt das Unternehmen, es gebe Anzeichen, dass das Modell oft erkenne, wenn es gerade getestet wird. Das erschwere die Einschätzung, wie es sich im echten Einsatz verhält.
Schneller Launch nach dem Ruf nach Tempolimit
Genau hier setzt die Kritik am Timing an. In seinem Essay „We Must Pace the Frontier“ hatte Amodei vor wenigen Tagen argumentiert, die KI-Branche solle langsamer werden, damit Sicherheitspraktiken mit den Fähigkeiten der Modelle Schritt halten können. Sein Drei-Stufen-Plan sieht laut TechCrunch eingebettete externe Prüfer:innen in den KI-Firmen vor, gemeinsame Sicherheitsstandards und „Limits für das Tempo ungebremsten KI-Fortschritts“ unter Vermittlung der US-Regierung sowie eine internationale Abstimmung, auch mit China. Den ersten Schritt setzt Anthropic einseitig um.
Nun folgt mit Opus 5.5 ein Modell, das den Index-Spitzenplatz übernimmt und die Preise senkt. Anthropic löst den scheinbaren Widerspruch selbst auf: Opus 5.5 sei „unser erstes Release, seit wir zum Pacing aufgerufen haben“, und es sei vorab von externen Evaluator:innen wie METR und Frontier Design getestet worden. Die Bremse ziele vor allem auf künftige Modelle, etwa solche, die KI-Forschung selbst vollständig automatisieren könnten. Für diese reichten die heutigen Schutzmaßnahmen nach eigener Einschätzung nicht aus, dort müsse auch die Politik eine größere Rolle spielen.
Ob diese Unterscheidung überzeugt, ist Ansichtssache. Kritische Stimmen wie ein Kommentar im Forbes meinen, Amodeis Vorschlag gehe ohnehin nicht weit genug. Befürworter:innen sehen im Pacing-Konzept eher ein Betriebsmodell für verantwortungsvolle Releases als einen Stopp. Fest steht: Der Wettbewerb mit OpenAI bleibt eng, und Anthropic hat keine Absicht, dabei zurückzufallen.
Verfügbarkeit
Claude Opus 5.5 ist ab sofort in den Claude-Apps, über die Claude Platform sowie bei Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. Für Abo-Kund:innen der Pläne Pro, Max, Team und Enterprise erhöht Anthropic zudem die Nutzungslimits. Ein Fast Mode mit bis zu 2,5-facher Geschwindigkeit kostet 8 beziehungsweise 40 Dollar (rund 7 beziehungsweise 35 Euro) pro Million Input- und Output-Tokens. Die kleineren Modelle Sonnet 5.5 und Haiku 5.5 sollen in den kommenden Wochen folgen.