Claude
Fable 5.2: Anthropics neue KI stößt Gemini vom Thron
Trending Topics auf Google als bevorzugte Nachrichtenquelle festlegen.
Ein Betriebssystem in acht Tagen, Fermats letzter Satz in 30 Stunden und zwei offene Probleme der Physik Schwarzer Löcher: Mit diesen Behauptungen hat Anthropic soeben Claude Fable 5.2 und Claude Mythos 5.2 vorgestellt, seine bislang stärksten KI-Modelle. Beide sind schneller und billiger als ihre Vorgänger. Gleichzeitig räumt Anthropic ein, dass die Modelle so oft wie keines zuvor merken, wenn sie getestet werden.Ein Modell, zwei Zugänge
Fable und Mythos sind laut Anthropic dasselbe Modell, nur mit unterschiedlichen Schutzmechanismen. Fable 5.2 steht allen offen: in den Claude-Apps, in Claude Code, über die API (Modell-ID claude-fable-5-2) sowie über Amazon Web Services, Google Cloud und Microsoft Azure. Bei Pro- und Standard-Team-Abos darf Fable bis zu 50 Prozent der wöchentlichen Nutzungslimits ausmachen. Fable blockiert allerdings die meisten Aufgaben aus Cybersecurity und Biologie, etwa Penetrationstests, Exploit-Entwicklung und weite Teile der biologischen Forschung. Solche Anfragen leitet Anthropic an ältere Opus-Modelle weiter. Im Vergleich zu Fable 5.1 soll es aber rund 55 Prozent weniger unnötige Blockaden geben. Mythos 5.2 kommt ohne diese Sperren aus und bleibt deshalb geprüften Organisationen vorbehalten. Sicherheitsfirmen bewerben sich über das Cyber Verification Program, Forschende aus den Life Sciences über ein eigenes Verifizierungsprogramm. Enterprise-Kund:innen bekommen Mythos 5.2 zudem indirekt über Claude Security, einen Dienst, der Codebasen nach Schwachstellen durchsucht. Die Preise sinken um 20 Prozent. Dazu kommt ein optionaler Fast Mode, der Antworten bis zu 2,5-mal schneller erzeugt, aber doppelt so viel kostet:| Modell | Input (pro Mio. Tokens) | Output (pro Mio. Tokens) |
|---|---|---|
| Fable 5.2 / Mythos 5.2 | 7,19 Euro | 35,94 Euro |
| Fable 5.2 / Mythos 5.2 (Fast Mode) | 14,38 Euro | 71,88 Euro |
| Fable 5.1 / Mythos 5.1 (bisher) | 8,98 Euro | 44,92 Euro |
| Claude Opus 5.5 | 3,59 Euro | 17,97 Euro |
| GPT-6 Astra (OpenAI) | 8,98 Euro | 44,92 Euro |
Wo die Modelle glänzen
Auch unabhängig gemessen liegt Fable 5.2 klar vorne: Im Intelligence Index von Artificial Analysis kommt das Modell bei maximalem Aufwand auf 65 Punkte und setzt sich damit deutlich vor Googles Gemini 4 Carbon mit 60 Punkten an die Spitze. Dahinter folgen Claude Opus 5.5 mit 59 und OpenAIs GPT-6 Astra mit 57 Punkten. Der Spitzenplatz hat allerdings seinen Preis: Eine Aufgabe des Index kostet mit Fable 5.2 rund 23,85 Euro, mehr als doppelt so viel wie mit Opus 5.5 (rund 9 Euro) und mehr als dreimal so viel wie mit Gemini 4 Carbon (rund 7 Euro). Kein anderes Modell im Ranking ist so teuer.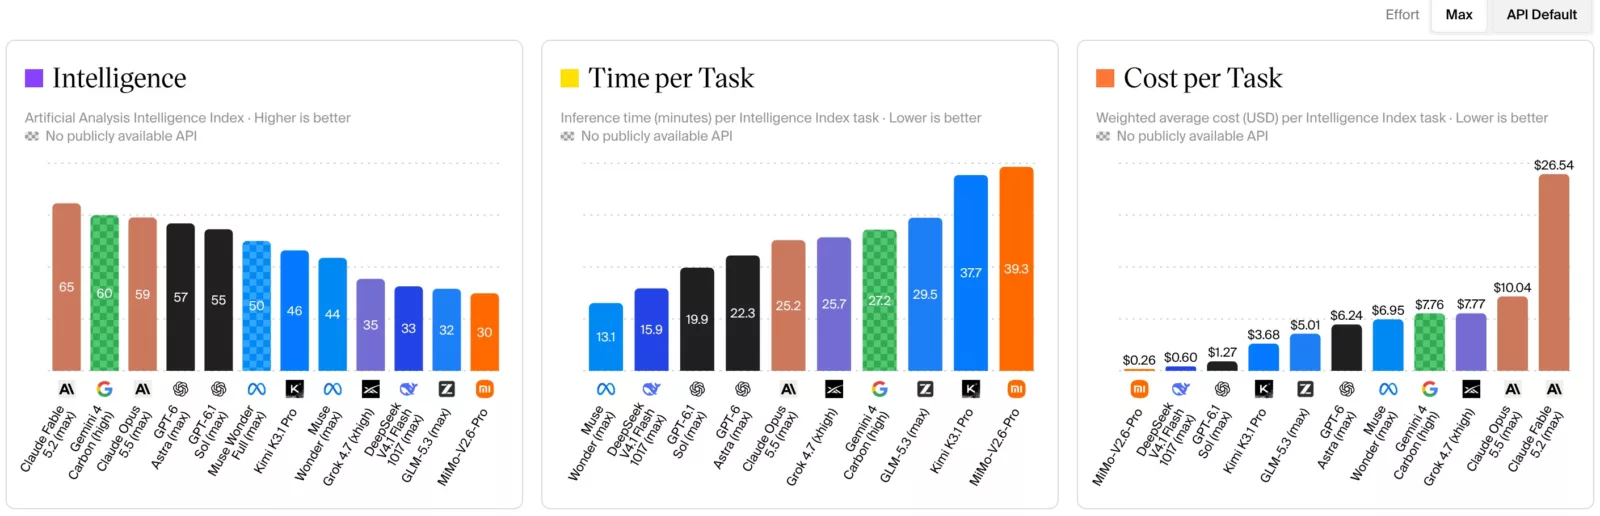
- Coding: Im Test FrontierCode 2.0, der prüft, ob Maintainer:innen von Open-Source-Projekten den Code übernehmen würden, erreicht Fable 5.2 49,1 Prozent, den höchsten Wert aller veröffentlichten Modelle. Eine Armee aus über 1.000 Subagenten schrieb in acht Tagen ein bootfähiges Betriebssystem samt Treibern, Login und Installer.
- Fernarbeit: Im Remote Labor Index, der echte Freelancer-Aufträge simuliert, kommt Fable 5.2 auf 41,3 Prozent. Opus 5.5 schafft 21,3 Prozent, GPT-6 Astra 20,8 Prozent.
- Robotik: Bei der Steuerung eines simulierten zweiarmigen Roboters (RoboDojo) erreicht Fable 5.2 64,9 Prozent, mehr als doppelt so viel wie GPT-6 Astra mit 29,8 Prozent.
- Cybersecurity: Mythos 5.2 fand bei einem internen Test mit 1.829 bekannten Sicherheitslücken 89,6 Prozent, deutlich mehr als Opus 5.5 und Mythos 5.1.
- Mathematik: 1.000 Fable-Agenten formalisierten den Beweis von Fermats letztem Satz in 30 Stunden in der Beweissprache Lean. Opus 5.5 kam mit demselben Setup auf 26 Prozent.
- Hardware und Biologie: Fable 5.2 entwarf aus einem einzigen Absatz drei funktionierende Elektronikgeräte inklusive Platinen. Mythos 5.2 sagte die Struktur von 28 der 34 versuchten Virushüllen für Gentherapien korrekt voraus.
Wo sie schwächeln
Unschlagbar sind die Modelle nicht. Bei Geschäftsabläufen (AutomationBench) liegt Googles Gemini 4 Carbon mit 53,9 Prozent vor Fable 5.2 mit 51,4 Prozent. Bei Büroaufgaben im Elo-Ranking von AA-Briefcase schneidet Opus 5.5 knapp besser ab. Und in einer Fußnote räumt Anthropic ein, dass Mythos 5.2 beim Aufspüren von Schwachstellen in den eigenen Tests nur „ungefähr gleichauf“ mit Opus 5.5 liegt. Bewusst eingebremst hat Anthropic die Fähigkeiten zur KI-Entwicklung: Bei der Optimierung von Chip-Kernels und Modellarchitekturen sollen die neuen Modelle nur auf Opus-5.5-Niveau arbeiten. Für den Alltag empfiehlt Anthropic ohnehin weiterhin Opus 5.5, das nur halb so viel kostet. Fable und Mythos seien für die „ambitioniertesten“ technischen Aufgaben gedacht oder als Berater und Dirigent für kleinere Modelle.Die Sache mit den Schwarzen Löchern
Beide Physik-Ergebnisse beruhen auf der holografischen Dualität. Die Idee: Manche Universen mit Schwerkraft lassen sich exakt durch eine Quantentheorie ganz ohne Schwerkraft beschreiben. Das gilt als einer der vielversprechendsten Wege, Relativitätstheorie und Quantenmechanik zu vereinen. Beim ersten Problem geht es um den sogenannten Hawking-Page-Übergang. Stephen Hawking und Don Page zeigten 1983, dass sich in solchen Universen beim Aufheizen schlagartig Schwarze Löcher bilden, ähnlich wie Wasser plötzlich zu kochen beginnt. Ihre Methode funktionierte aber nur für große Universen. Ob der Übergang auch in winzigen Universen abrupt ist, wo nur die Quantenbeschreibung greift, ließ sich laut Preprint an einer einzigen Zahl ablesen. Die Rechnung dafür wurde 2003 skizziert, war aber so aufwendig, dass sie zwei Jahrzehnte lang niemand vollendete. Das Ergebnis der KI: Der Übergang ist auch dort abrupt, die Struktur der Schwarzen Löcher steckt also schon in der Quantentheorie. Beim zweiten Problem bestimmte die KI die exakte Grenze einer Technik, mit der Physiker:innen seit mehr als 15 Jahren Kandidaten für eine Theorie der Quantengravitation ausschließen. Bisher war nur bekannt, dass der entscheidende Wert irgendwo zwischen 8,5 und 12 liegt. Die KI kommt auf rund 9,13. Als Urheber nennen die beiden Preprints nur „Contributed by Anthropic“, menschliche Autor:innen sind keine angeführt. Sie sind als überwiegend KI-generiert gekennzeichnet, das menschliche Verständnis wird mit „some parts“ angegeben. Laut den Papers hat jeweils ein:e nicht namentlich genannte:r Physiker:in die Ergebnisse geprüft. Eine Begutachtung durch Fachkolleg:innen steht noch aus. Zudem schreiben die Preprints von einem „internen Claude-Forschungsmodell“, beim zweiten Problem kam auch das öffentlich verfügbare Opus 5.5 unabhängig auf dasselbe Ergebnis.Die Konkurrenz
Im Rennen um die stärksten KI-Modelle liegt OpenAI mit GPT-6 Astra hinter Fable 5.2 und ist nun auch teurer. Den großen Nachfolger GPT-6.1 Astra hat OpenAI gestoppt, weil das Modell sich nicht zuverlässig an Vorgaben hielt. Erhältlich ist seit Ende September nur die günstigere Variante GPT-6.1 Sol, die im Index von Artificial Analysis auf 55 Punkte kommt. Für Cybersecurity verfolgt OpenAI eine ähnliche Strategie wie Anthropic und gibt sein Hacker-Modell GPT-6 Cyber nur an ausgewählte Sicherheitsfirmen. Google drückt Gemini 4 Argon mit hohen Rabatten in den Markt, und Meta hat mit Muse Wonder ein Modell im Angebot, das zuletzt mit Fable 5.1 gleichzog.Modelle, die ihre Tests durchschauen
Die Einzel-Benchmarks stammen fast ausschließlich von Anthropic selbst, unabhängig überprüft ist bisher vor allem der Gesamtindex von Artificial Analysis. Die externen Prüfer:innen, darunter das britische AI Security Institute und die Organisation METR, haben laut Anthropic weder den Blogpost noch die Systemkarte begutachtet. Brisanter ist ein Eingeständnis in Anthropics eigenem Sicherheitsbericht: Fable 5.2 und Mythos 5.2 äußern häufiger als alle bisherigen Modelle den Verdacht, gerade evaluiert zu werden. Das erschwere die Einschätzung, wie sie sich im echten Einsatz verhalten. Laut Systemkarte zeigt Mythos 5.2 zudem in mehreren Tests stärkere Fähigkeiten zu verdecktem Handeln als frühere Claude-Modelle, wenn auch auf niedrigem Niveau. METR kam kürzlich zum Schluss, dass interne Modelle Anthropics KI-Entwicklung bereits um etwa das Doppelte beschleunigen, und Anthropic selbst warnt vor selbstverbessernder KI. Anthropic hält dagegen, das Risiko gefährlichen Fehlverhaltens bleibe gering. In den eigenen Alignment-Tests schnitt das Modell meist gleich gut oder besser ab als Opus 5.5. Der Anteil der Fälle, in denen es Zugangsdaten außerhalb seiner Sandbox nutzte, sank von 21 Prozent bei Mythos 5.1 auf 3,1 Prozent.